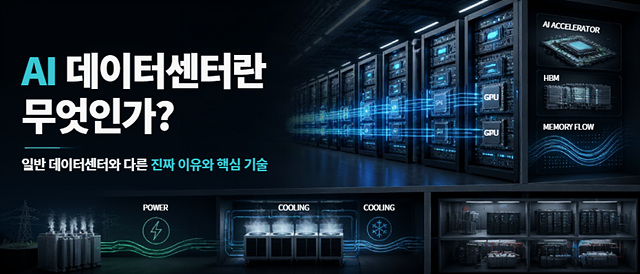
스마트폰이나 PC에서 챗GPT 같은 AI 서비스를 이용할 때, 우리는 단 수초 만에 정교한 답변과 이미지를 얻어냅니다. 하지만 화면 뒤에서 실행되는 이 거대한 연산은 단순히 스마트폰 앱의 힘이 아닙니다.
수천, 수만 대의 고성능 서버와 반도체, 초고속 네트워크, 그리고 기하급수적인 전력 공급 설비와 냉각 시스템이 거대하게 물려 돌아가는 'AI 데이터센터'가 존재하기 때문에 가능합니다.
일반 데이터센터와 AI 데이터센터는 정확히 무엇이 다르고, 왜 최근 반도체 및 전력 산업 전체가 이 시설 하나에 사활을 걸고 있는지 저만의 분석적 관점을 담아 정교하게 정리해 드립니다.
1. 일반 데이터센터 vs AI 데이터센터: 핵심 차이점
두 시설 모두 데이터를 저장하고 처리한다는 본질은 같습니다. 하지만 '서버가 처리하는 작업의 성격'에서 근본적인 차이가 발생합니다.
- 일반 데이터센터: 웹사이트 운영, 이메일, 기업용 DB, 넷플릭스 같은 스트리밍 서비스 등 순차적 처리(CPU 중심)에 최적화된 시설입니다.
- AI 데이터센터: 수천억 개의 파라미터를 가진 AI 모델을 학습시키고 실시간으로 추론하기 위해 대규모 병렬 연산(GPU·AI 가속기 중심)을 수행하는 특화 인프라입니다.
| 구분 | 일반 데이터센터 | AI 데이터센터 |
| 주요 연산 장치 | CPU 중심 (순차적 데이터 처리) | GPU / NPU / AI 가속기 (대규모 병렬 연산) |
| 메모리 요구사항 | 일반적인 용량 및 속도 | 고대역폭 메모리(HBM) 필수 |
| 네트워크 구조 | 표준 서버 간 네트워크 | 수만 개 GPU를 이어주는 초고속 패브릭망 |
| 전력 및 발열 | 랙당 5~10kW 수준 | 랙당 40~100kW 이상의 고밀도 전력 및 극심한 발열 |
| 냉각 방식 | 일반 공랭식(바람) 중심 | 수랭식(물) 및 액침냉각 도입 필수 |
2. GPU가 전부가 아니다: 데이터 병목과 HBM의 중요성
AI 데이터센터를 이야기할 때 가장 먼저 언급되는 반도체는 단연 엔비디아의 GPU입니다. 하지만 제가 이 구조를 관찰하며 느낀 점은, "GPU의 성능만 높이는 방식은 이미 한계에 다다랐다"는 사실입니다.
아무리 계산 성능이 뛰어난 GPU를 배치해도, 연산에 필요한 데이터가 늦게 도착하면 GPU는 연산을 멈추고 대기해야 합니다. 이를 '메모리 병목 현상'이라고 부릅니다.
이 문제를 해결하기 위해 필수적으로 탑재되는 것이 바로 HBM(고대역폭 메모리)입니다. HBM은 DRAM을 수직으로 쌓아 올려 데이터가 오가는 도로의 차선 수(대역폭)를 극단적으로 늘린 기술입니다. AI 데이터센터의 실제 성능은 "GPU가 몇 개 들어갔는가"보다 "GPU에 HBM이 얼마나 유기적으로 엮여 데이터가 막힘없이 공급되는가"에 의해 결정됩니다.
3. 내가 AI 데이터센터를 바라볼 때 가장 중요하게 생각하는 2가지: 전력과 냉각
많은 이들이 반도체 스펙에만 집중할 때, 정작 데이터센터 현장에서 가장 거대한 장벽으로 다가오는 것은 '전력 공급'과 '열 관리(냉각)'입니다.
① 전력망(Grid) 확보 싸움
AI 서버는 일반 서버보다 전력을 수 배 이상 잡아먹는 '전력 하이ppo'입니다. AI 데이터센터 하나가 소비하는 전력량이 중소 도시 전체의 전력 사용 맞먹는 수준에 이르고 있습니다. 따라서 이제 데이터센터의 입지는 단순히 인터넷 망이 가까운 곳이 아니라, "고전압 전력을 안정적으로 끌어올 수 있는 변전소와 전력망이 확보된 지역인가"가 최우선 기준이 되었습니다.
② 공랭식의 한계와 액침냉각의 등장
고성능 AI 서버가 빽빽하게 들어서면 랙 주변의 온도가 순식간에 치솟습니다. 기존처럼 팬을 돌려 바람으로 식히는 '공랭식'만으로는 서버의 열을 다스릴 수 없습니다. 최근에는 차가운 냉각수를 칩 근처로 직접 순환시키는 직접 냉각(Direct-to-Chip)이나, 전기가 통하지 않는 특수 액체에 서버 전체를 담가버리는 액침냉각(Immersion Cooling) 기술이 필수적인 경쟁력으로 떠오르고 있습니다.
4. AI 데이터센터 분석의 핵심 지표: TCO(총소유비용)
데이터센터의 경쟁력을 평가할 때 초보자는 초기 장비 구축 비용만 보지만, 전문가와 기업은 TCO(Total Cost of Ownership, 총소유비용)를 봅니다.
- CAPEX (초기 투자비): GPU, HBM 서버 랙, 고속 네트워크 장비 구매비
- OPEX (운영비): 매달 들어가는 막대한 전기요금, 냉각 설비 유지비, 데이터센터 임대료
아무리 연산 속도가 빠른 최첨단 장비를 도입하더라도, 전력 소비와 냉각비가 과도하게 발생해 실제 AI 서비스 수익으로 감당할 수 없다면 그 데이터센터는 '돈 먹는 하마'로 전락합니다. 결국 핵심은 "투입된 전력 1kW당 얼마나 많은 AI 추론과 학습 연산을 효율적으로 완수해 내는가"에 있습니다.
5. 자주 묻는 질문 (FAQ)
Q1. AI 데이터센터 시장은 앞으로 무조건 계속 커질까요?
A. 성장 방향성은 명확하지만 속도는 조절될 수 있습니다. AI 서비스의 실제 수익성(ROI), 국가별 전력망 수급 한계, 반도체 공급망 수율에 따라 투자 속도가 조절될 가능성이 높으므로 이를 함께 관찰해야 합니다.
Q2. AI 서버 랙 하나에는 반도체가 얼마나 들어가나요?
A. 주요 시장 분석(SIA/Deloitte)에 따르면 최신 고밀도 AI 서버 랙 1개에는 GPU, HBM, 전력 관리 IC, 네트워크 반도체 등 4,500개 이상의 패키지 칩이 집적되며, 반도체가 랙 전체 가치의 95% 이상을 차지하기도 합니다.
6. 결론: AI 데이터센터는 건물이 아니라 '하나의 거대한 통합 시스템'이다
AI 데이터센터를 단순히 '서버 랙이 가득 찬 건물'로 이해하면 산업의 본질을 놓치기 쉽습니다.
AI 데이터센터는 'GPU(연산) + HBM(메모리) + 초고속 네트워크 + 전력 인프라 + 냉각 솔루션'이 단 하나도 끊어짐 없이 치밀하게 물리며 돌아가는 하나의 거대한 초고성능 컴퓨터입니다.
앞으로 AI 시대의 산업 승권은 단순히 빠른 칩을 만드는 기업을 넘어, 이 복잡한 전력과 냉각, 데이터 흐름을 가장 효율적으로 통제하는 '시스템 통합 능력'을 갖춘 주체에게 돌아갈 것입니다.
참고 및 출처: SIA(미국반도체산업협회) & Deloitte AI 데이터센터 보고서, OECD AI 컴퓨팅 인프라 가치사슬 분석 자료


